LivePortraitの研究実装
Kuaishou Technology · ポートレートアニメーション · 画像・動画ワークフロー
元画像と動きの方向を選んで、ポートレートに命を吹き込みましょう。
🔥 更新情報
2025/06/01: 🌍 この1年で、 LivePortrait は人物、猫、犬に対応する効率的なポートレートアニメーション生成ソリューションとなり、動画プラットフォーム、クリエイティブツール、研究ワークフローで活用されています。2025/01/01: 🐶 Animalsモデルに学習データを追加し、サンプル素材を更新しました。詳細は こちら.2024/10/18: ❗ インストールの安全性と一貫性を高めるため、依存ライブラリのバージョンを更新しました。詳しくは 変更履歴.2024/08/29: 📦 Windowsパッケージを更新し、セットアップ手順を簡素化するとともに、アップデートに対応しました。2024/08/19: 🖼️ ポートレートの動きをより細かく制御できる画像駆動モードと領域別制御に対応しました。2024/08/06: 🎨 表情をより細かく制御できる、精密なポートレート編集機能をインターフェースに追加しました。2024/08/05: 📦 Windowsユーザーは、HumansモードとAnimalsモードの両方に対応したワンクリックパッケージを利用できます。2024/08/02: 😸 新しいAnimalsモデルを公開し、複数の改良も加えました。2024/07/25: 📦 ダウンロード可能なパッケージに、Windowsユーザー向けの直接実行手順を追加しました。2024/07/24: 🎨 元のポートレートのポーズ編集に対応し、検出しきい値のデフォルト値を引き下げました。2024/07/19: ✨ 対応するワークフローで、v2vとも呼ばれるポートレート動画編集を利用できます。2024/07/17: 🍎 HumansワークフローがApple Siliconに対応しました。2024/07/10: 💪 音声と動画の連結、駆動動画の自動クロップ、モーションテンプレートの作成に対応しました。2024/07/09: 🤗 ローカル環境のセットアップなしで試せるオンラインデモを公開しました。2024/07/04😊:初期の推論コードとモデルが、研究および実験用に公開されました。2024/07/04🔥:プロジェクトのホームページと技術レポートが、最初の一般公開実装とともに公開されました。
はじめに 📖
このリポジトリ(名称: LivePortrait)には、ステッチングとリターゲティング制御に対応した、効率的なポートレートアニメーションのための公式PyTorch実装が含まれています。このワークフローでは、元のアイデンティティと視覚的構造の一貫性を保ちながら、ソースポートレートに表情豊かな動きを加えます。
LivePortraitは、研究、クリエイティブな探究、実用的な画像から動画への実験に向けて積極的に改良されています。問題を見つけた場合や提案がある場合は、プロジェクトのワークフローを利用して共有してください。
はじめに 🏁
1. コードをクローンして環境を準備する 🛠️
注記
ローカルワークフローを実行する前に、システムに git, condaと FFmpeg がインストールされていることを確認してください。
git clone https://github.com/KlingTeam/LivePortrait
cd LivePortrait

# create env using conda
conda create -n LivePortrait python=3.10
conda activate LivePortrait
Linux 🐧 または Windows 🪟 ユーザー向け
X-Pose依存関係はAnimalsモードで必要です。Humansモードのみを実行する場合、CUDAバージョンの確認は任意です。
CUDAバージョンを確認する
まず、インストールされているCUDAバージョンを確認します:
nvcc -V # example versions: 11.1, 11.8, 12.1, etc.次に、対応するtorchバージョンをインストールします。以下はコマンド例です:
# for CUDA 11.1
pip install torch==1.10.1+cu111 torchvision==0.11.2 torchaudio==0.10.1 -f https://download.pytorch.org/whl/cu111/torch_stable.html

# for CUDA 11.8
pip install torch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 --index-url https://download.pytorch.org/whl/cu118

# for CUDA 12.1
pip install torch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 --index-url https://download.pytorch.org/whl/cu121
最後に、残りの依存関係をインストールします:
pip install -r requirements.txtApple Silicon搭載macOS ユーザー向け
X-Pose依存関係はmacOSをサポートしていないため、スキップできます。Humansモードは通常どおり動作しますが、Animalsモードはこのプラットフォームではサポートされていません。
# for macOS with Apple Silicon users
pip install -r requirements_macOS.txt
2. 事前学習済み重みをダウンロードする 📥
事前学習済み重みをダウンロードする最も簡単な方法は、Hugging Faceのコマンドラインクライアントを使用することです:
# !pip install -U "huggingface_hub[cli]"
huggingface-cli download KlingTeam/LivePortrait --local-dir pretrained_weights --exclude "*.git*" "README.md" "docs"
メインミラーを利用できない場合は、代替エンドポイントを使用してください:
# !pip install -U "huggingface_hub[cli]"
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download KlingTeam/LivePortrait --local-dir pretrained_weights --exclude "*.git*" "README.md" "docs"
または、リンク先のプロジェクトリソースから重みの完全なパッケージをダウンロードし、解凍したファイルを ./pretrained_weights.
に配置してください。推論を開始する前に、ディレクトリ構造が想定されるレイアウトと一致していることを確認してください。
3. 推論 🚀
高速ハンズオン(人物)👤
# For Linux and Windows users
python inference.py

# For macOS users with Apple Silicon
PYTORCH_ENABLE_MPS_FALLBACK=1 python inference.py
正常に実行されると、出力動画 animations/s6--d0_concat.mp4が生成されます。これは、駆動動画、ソース画像または動画、生成結果を組み合わせたものです。
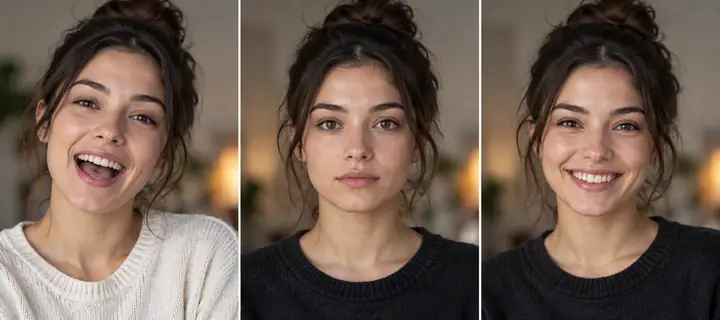
source 引数と driving 引数を指定して、入力を変更できます:
# source input is an image
python inference.py -s assets/examples/source/s9.jpg -d assets/examples/driving/d0.mp4

# source input is a video
python inference.py -s assets/examples/source/s13.mp4 -d assets/examples/driving/d0.mp4

# more options
python inference.py -h
高速ハンズオン(動物)🐱🐶
動物モードは、NVIDIA GPUを搭載したLinuxおよびWindowsでテストされています。
まず MultiScaleDeformableAttention 操作をビルドし、その後、動物推論スクリプトを実行します:
cd src/utils/dependencies/XPose/models/UniPose/ops
python setup.py build install
cd -
python inference_animals.py -s assets/examples/source/s39.jpg -d assets/examples/driving/wink.pkl --driving_multiplier 1.75 --no_flag_stitching正常に実行されると、 animations/s39--wink_concat.mp4.
駆動動画の自動クロップ 📢📢📢
重要
ご自身の駆動動画には、以下を推奨します:
- 次のアスペクト比にクロップする: 1:1 、または
--flag_crop_driving_video. - 頭部を目立たせ、肩の動きを最小限に抑えてください。
- 最初のフレームでは、正面を向いた顔で、ニュートラルな表情を使用してください。
以下に自動クロップの例を示します:
python inference.py -s assets/examples/source/s9.jpg -d assets/examples/driving/d13.mp4 --flag_crop_driving_video自動クロップの調整が必要な場合は、 --scale_crop_driving_video と --vy_ratio_crop_driving_video を調整してください。
モーションテンプレートの作成
で終わる自動生成モーションテンプレートは、 .pkl 推論を高速化し、ソース動画のプライバシー保護に役立ちます:
python inference.py -s assets/examples/source/s9.jpg -d assets/examples/driving/d5.pkl  # portrait animation
python inference.py -s assets/examples/source/s13.mp4 -d assets/examples/driving/d5.pkl  # portrait video editing
4. Gradioインターフェース 🤗
このプロジェクトには、より利用しやすいワークフローのためのGradioインターフェースが含まれています:
# For Linux and Windows users
python app.py

# For macOS with Apple Silicon
PYTORCH_ENABLE_MPS_FALLBACK=1 python app.py
Animalsモードには個別のインターフェースがあり、NVIDIA GPU搭載のLinuxでテストされています:
python app_animals.py必要に応じて --server_port, --share、および --server_name を指定できます。
オプションの --flag_do_torch_compile モードを使用すると、初回の最適化ステップ後に、その後の推論を高速化できます:
# enable torch.compile for faster inference
python app.py --flag_do_torch_compile注記: torch.compileはWindowsおよびmacOSではサポートされていません。
または、次を通じてオンラインワークフローをお試しください: LivePortrait 🤗
5. 推論速度の評価 🚀🚀🚀
速度スクリプトを使用して、各モジュールの推論時間を評価します:
# For NVIDIA GPU
python speed.py
測定に関する注記は、プロジェクトのリソースで確認できます。
コミュニティリソース 🤗
LivePortraitコミュニティが提供するツールや学習リソースをご覧ください。
コミュニティ開発プロジェクト
| リポジトリ | 説明 | 作者 / リンク |
|---|---|---|
| AVTR-1 | dyadic音声コンディショニングとLivePortraitスタイルのポートレートワーピングレンダラーを使用した、リアルタイムの会話型トーキングヘッドモデル。 | @avaturn-live |
| ditto-talkinghead | リアルタイム音声駆動トーキングヘッド。 | ArXiv, ホームページ |
| FasterLivePortrait | TensorRTを使用した、より高速なリアルタイム版。 | @warmshao |
| AdvancedLivePortrait-WebUI | 高度なLivePortraitノードワークフローをもとに始められた、Gradioベースの専用WebUI。 | @jhj0517 |
| FacePoke | カーソルで操作するリアルタイムの頭部変換アプリ。 | @jbilcke-hf |
| FaceFusion | FaceFusionは、表情復元および顔編集プロセッサとしてLivePortraitを統合しています。 | @henryruhs |
| sd-webui-live-portrait | 既存のStable DiffusionワークフローにLivePortrait機能を追加するWebUI拡張。 | @dimitribarbot |
| ComfyUI-LivePortraitKJ | InsightFaceの代替としてMediaPipeを使用するComfyUIノード。 | @kijai |
| ComfyUI-AdvancedLivePortrait | 多くのコミュニティツールに影響を与えた、リアルタイムプレビュー対応のより高速なComfyUIノード。 | @PowerHouseMan |
| comfyui-liveportrait | 複数の顔と表情の補間に対応するComfyUIノード。 | @shadowcz007 |
Playground、🤗 HuggingFace Spaces その他
- FacePoke Space
- Expression Editor Space
- Expression Editor Replicate
- Face Control Realtime Demo FAL上
- Replicate Playground
- Nukeではコミュニティノードを通じてLivePortraitを使用できます。詳細はこちらです こちら.
- LivePortraitは次のサービスでも利用できます Poe.
動画チュートリアル
- LivePortraitの動画から動画へのワークフロー 作成者: @curiousrefuge
- Google Colabチュートリアル 作成者: @Planet Ai
- 論文解説 作成者: @TwoMinutePapers
- ComfyUI Advanced LivePortrait 作成者: TutoView
- LivePortraitの探究 と LivePortraitを深掘り による TheoreticallyMedia
- LivePortrait実践チュートリアル による @AI Search
- ComfyUIチュートリアル による @Sebastian Kamph
- 1つの チュートリアル BiliBili上の
そして、コミュニティからの多くの思慮深い貢献が、LivePortraitのエコシステムをさらに発展させ続けています 💖
謝辞 💐
FOMM、Open Facevid2vid、SPADE、InsightFace、X-Pose、およびより広範なオープンリサーチコミュニティの貢献者の皆様に、その研究と貢献に感謝します。
倫理的な配慮 🛡️
ポートレートアニメーション技術には、欺瞞的なメディアの作成に悪用される可能性など、社会的なリスクが伴います。ワークフローは責任を持って使用し、元画像の使用許可を取得し、必要に応じて合成または編集された結果であることを明確に示してください。現在の合成結果には、検出に役立つ可能性のある視覚的なアーティファクトが含まれる場合があります。本プロジェクトは、生成された出力について法的責任を負いません。
引用 💖
LivePortraitがあなたのプロジェクトや研究に役立つ場合は、以下のBibTeXを使用してこの研究を引用してください。
@article{liveportrait2024,
  title   = {LivePortrait: Efficient Portrait Animation with Stitching and Retargeting Control},
  author  = {LivePortrait Research Team},
  journal = {arXiv preprint},
  year    = {2024}
}
オープンリサーチ万歳。
お問い合わせ 📧
LivePortrait Research;ご質問や共同研究の依頼は、 プロジェクトのワークフロー.
スター履歴 🌟
クリックしてスターチャートを表示